人工智能视觉 从图像识别到多模态理解的技术演进
引言
人工智能视觉(Computer Vision,简称CV)是人工智能领域最活跃、发展最迅猛的分支之一。它的核心目标是让机器“看懂”世界——从像素级的图像数据中提取语义信息,完成分类、检测、分割、生成等任务。在过去十年中,深度学习尤其是卷积神经网络(CNN)和视觉Transformer(ViT)的兴起,彻底改变了这一领域的研究范式与应用格局。
一、技术基石:从CNN到视觉Transformer
早期的计算机视觉依赖手工特征(如SIFT、HOG)和传统机器学习分类器。2012年AlexNet在ImageNet竞赛中的突破,宣告了深度卷积网络时代的到来。VGG、GoogLeNet、ResNet等架构不断深化网络,残差连接解决了梯度消失问题,使超深网络训练成为可能。
2020年后,Transformer从自然语言处理迁移至视觉领域。ViT将图像切分为补丁序列,通过自注意力机制建模全局依赖关系,在大规模数据上展现出超越CNN的性能。此后,Swin Transformer、MAE等模型进一步推动了视觉自监督学习的发展。如今,卷积与注意力机制的混合架构(如ConvNeXt)也成为重要方向。
二、核心任务与典型应用
人工智能视觉涵盖多个基础任务:
- 图像分类:判断图像所属类别,是视觉理解的入门任务。
- 目标检测:定位并识别图像中的多个物体,代表算法有YOLO系列、Faster R-CNN、DETR等。
- 语义分割与实例分割:为每个像素分配类别标签,应用于自动驾驶、医学影像分析。
- 图像生成:以GAN、扩散模型为代表,实现文生图、图像修复、风格迁移。
- 视频理解:包括动作识别、目标跟踪、视频问答,是时序视觉的重要方向。
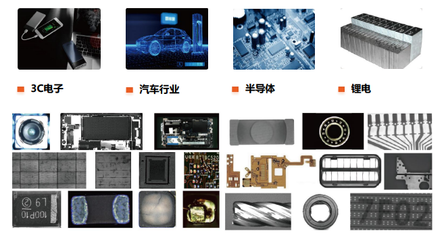
在实际应用中,人工智能视觉已深入工业质检、人脸识别、无人驾驶、智慧医疗、遥感解译、增强现实等领域。例如,在医学影像中,AI可辅助检测肺结节、视网膜病变;在工业中,视觉系统能以亚毫米精度完成缺陷检测。
三、与自然语言处理的融合:多模态学习
视觉与自然语言处理的交叉催生了多模态大模型。CLIP通过对比学习将图像与文本映射到同一嵌入空间,实现零样本分类。BLIP、Flamingo、GPT-4V等模型进一步支持图像描述、视觉问答、图文推理。这种跨模态能力使AI不仅能“看”,还能“说”和“推理”,推动了具身智能与通用人工智能的探索。
四、挑战与未来展望
尽管进展显著,人工智能视觉仍面临诸多挑战:
- 数据偏见与鲁棒性:模型在分布外数据上性能骤降,对抗攻击仍是安全隐患。
- 可解释性:深度网络决策过程不透明,在医疗、司法等高风险场景需谨慎。
- 计算效率:大模型部署成本高,边缘设备需轻量化设计。
- 三维与动态场景:从2D图像到3D点云、神经辐射场(NeRF)、动态视频的建模仍需突破。
- 因果与常识推理:当前模型缺乏对物理世界和社会常识的深层理解。
人工智能视觉将朝着自监督、多模态、具身智能、可解释与高效计算的方向发展。随着神经辐射场、扩散模型、状态空间模型(如Mamba)等新范式的涌现,视觉系统有望在开放世界中实现更接近人类的感知与理解能力。
##
人工智能视觉是连接感知与认知的桥梁。它既是深度学习技术的试验场,也是通向通用人工智能的关键路径。从识别猫狗到理解复杂场景,从静态图像到实时视频,这场“视觉革命”仍在加速演进,值得持续关注与投入。
如若转载,请注明出处:http://www.thznzc.com/product/49.html
更新时间:2026-10-02 16:02:11